
Силиконовый воротник превращает беззвучную речь в голос
Южнокорейские исследователи создали силиконовый воротник, который фиксирует движения шеи при беззвучном произнесении слов и с помощью ИИ преобразует их в речь, максимально похожую на голос пользователя. Технология может применяться в медицине и в условиях сильного шума, где обычные микрофоны неэффективны.
Ingenium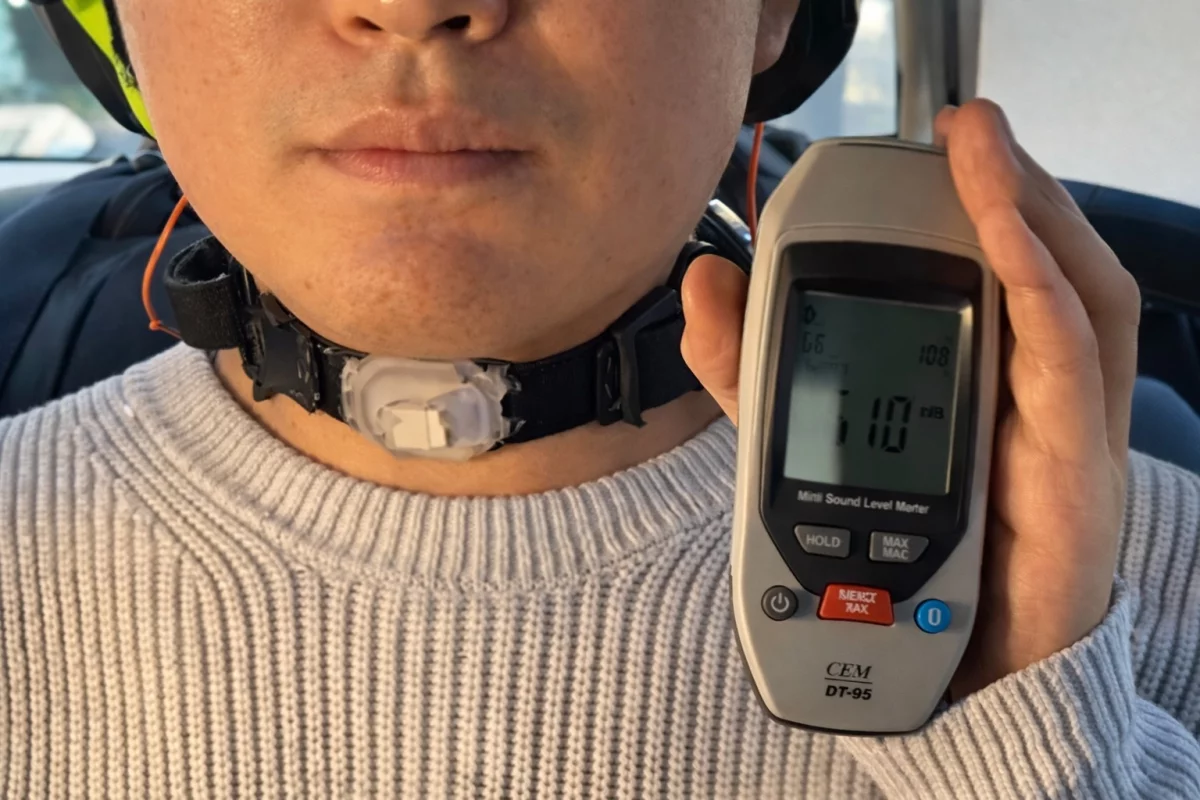
Исследователи из Университета науки и технологий POSTECH в Южной Корее разработали силиконовый воротник, способный фиксировать мельчайшие движения шеи при беззвучном произнесении слов и преобразовывать их в речь, воспроизводимую голосом пользователя для передачи слушателю.
Принцип работы устройства
Устройство основано на том, что формирование слов сопровождается характерными движениями мышц и кожи шеи, создающими уникальные паттерны для каждого слога. Ранее для фиксации этих сигналов применялись электромиография (ЭМГ) и электроэнцефалография (ЭЭГ), однако такие методы требовали громоздкого оборудования и были неудобны вне лабораторных условий.
Команда POSTECH использовала иной подход: воротник сочетает мягкий силикон, миниатюрную камеру и датчики движения, работающие совместно с искусственным интеллектом, обученным на голосе пользователя. Многовекторный сенсор отслеживает степень и направление деформации кожи при артикуляции, что позволяет получить подробную картину работы рта и горла. Маркеры, нанесённые на силиконовый воротник, позволяют камере измерять эти деформации в реальном времени.
Алгоритм корректирует небольшие различия в положении устройства при каждом надевании, обеспечивая стабильность показаний. Полученные паттерны деформации поступают в ИИ-модель, которая определяет произнесённое слово.
Тестирование и эффективность
В ходе испытаний система обучалась на словах фонетического алфавита НАТО, специально разработанного для разборчивости в сложных условиях. При работе с 26 словами точность распознавания составила 85,8%. После распознавания слово по беспроводной связи отправляется на сервер, где с помощью персонализированной модели преобразования текста в речь синтезируется аудиофайл, максимально приближённый к реальному голосу пользователя. Для обучения голосовой модели требуется менее 10 минут записей.
Система показала устойчивость к сильным помехам: при уровне шума около 90 дБ (сравнимо со строительной площадкой) сохранялось отношение сигнал/шум до 33,75 дБ, что превышает показатели коммерческих ЭМГ-систем в аналогичных условиях.
Ограничения и перспективы
Текущая версия устройства работает только с фиксированным словарём из 26 заранее заданных слов, свободная речь невозможна. Точность может снижаться до 39,72% при движении пользователя или активных поворотах головы. Дальнейшие планы включают расширение словаря, тестирование на большем числе пользователей и улучшение компенсации движений тела.
Возможные применения
Технология может использоваться не только в медицине, например, для пациентов после ларингэктомии, но и в условиях, где обычные микрофоны неэффективны или недоступны: на промышленных объектах, в службах экстренного реагирования, авиации, морских операциях и военных сценариях. Система была протестирована не только при белом шуме, но и во время демонстрации газового ружья, где присутствовали шум и вибрация.
Сравнение с другими разработками
Ранее аналогичные подходы тестировались в лабораториях, например, в Кембриджском университете, где также использовались воротники с датчиками для обнаружения вибраций горла при беззвучном произнесении слов. Прототип Кембриджа достигал точности декодирования речи 95,25% и не ограничивался конкретным словарём. В недавних исследованиях их система также определяла эмоциональное состояние пользователя. Особенностью разработки POSTECH является применение искусственного интеллекта для воссоздания индивидуального голоса пользователя.